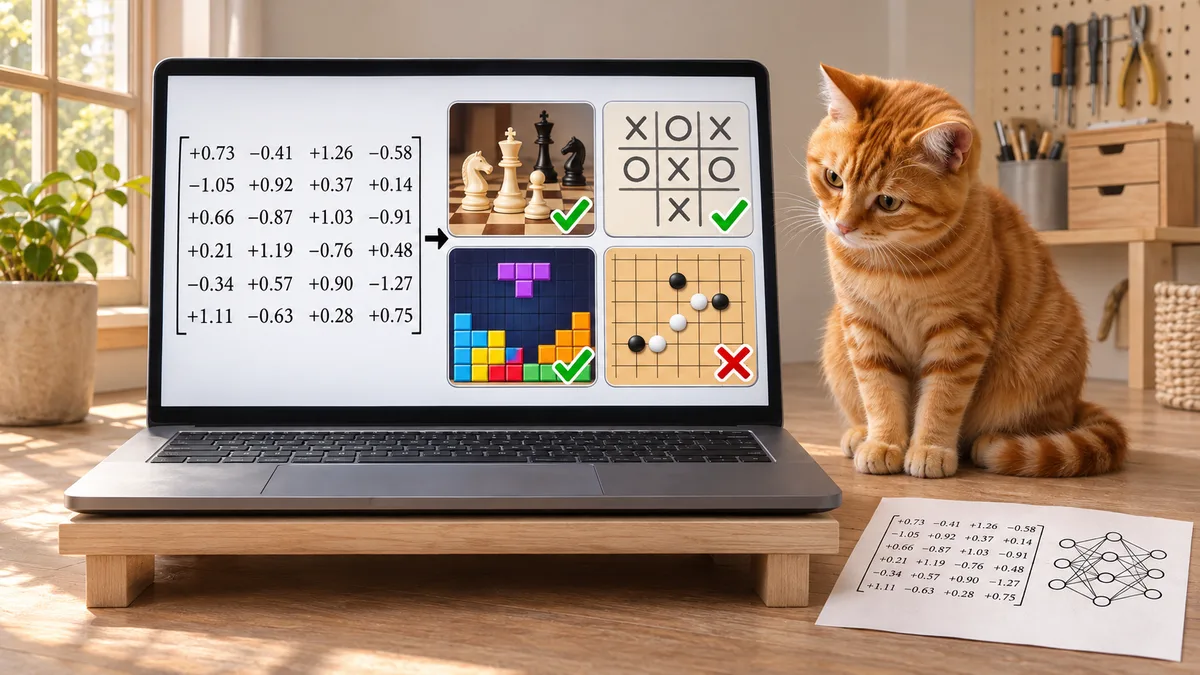
쿠웬(Qwen) 3.8 27B가 노트북에서 게임용 신경망의 가중치만 읽고 어떤 게임을 학습했는지 네 번 중 세 번 맞혔다. 개발자 사이먼 윌리슨(Simon Willison)은 거대 모델이 숫자로 된 가중치를 해석한다는 연구를 보고, 같은 문제를 자신이 로컬에서 쓰는 모델에 풀게 했다. 결과는 눈길을 끌지만, 숫자를 읽어 모델의 용도를 알아맞히는 일과 가중치를 고쳐 성능을 높이는 일은 구분해야 한다. 이번 실험은 그 경계를 살펴볼 만한 사례다.
핵심요약
- 윌리슨은 도구나 코드 실행 없이 게임용 신경망의 가중치를 읽는 실험을 쿠웬 3.8 27B로 재현해 네 게임 중 세 게임을 맞혔다.
- 연구진은 GPT-6 아스트라가 다른 모델의 가중치를 고쳐 성능을 높인 사례도 소개했지만, 이는 게임 가중치를 읽는 실험과 조건이 다르다.
- 쿠웬은 팩맨·퐁·브레이크아웃을 맞히는 데 각각 수십 분을 썼으며, 프리웨이는 팩맨과 비슷한 게임으로 잘못 판단했다.
- 공개된 문제에서 각 게임의 질문은 가중치만 달랐으므로, 결과는 숫자로 표현된 모델의 행동을 추론하는 능력을 보여준다.
- 토론에서는 정답 검증, 문제 파일의 단서, 가중치 수정이 다른 능력에 미칠 영향이 주요 쟁점으로 떠올랐다.
가중치를 읽는 일과 고치는 일
윌리슨이 따라 해 본 출발점은 ‘가중치 공간 프로그래밍(Weight-Space Programming)’이라는 연구였다. 가중치(신경망의 연결과 계산에 쓰이는 수치)를 모델이 직접 살펴보고, 필요하면 바꿀 수도 있다는 주장이다. 연구진은 GPT-6 아스트라(GPT-6 Astra)가 숫자로 적힌 가중치만 보고 신경망이 무엇을 하도록 학습됐는지 파악했다고 소개했다. 또 환경에서 결과를 확인하지 않고도 작은 게임용 신경망을 처음부터 작성해, PPO(강화학습 알고리즘)로 1억 단계를 학습한 신경망보다 나은 성적을 냈다고 밝혔다.
연구에는 기존 언어모델을 손보는 사례도 들어 있다. 연구진은 아스트라가 쿠웬 3.5-0.8B의 추론이 반복되는 문제를 찾아 가중치의 0.016%를 수정했고, 같은 샘플링 설정에서 수학 평가인 MATH-500 점수가 7.9%에서 48.1%로 올랐다고 설명했다. 지시 이행 평가인 IFEval 점수도 3배가 됐다는 것이 연구진의 발표다. 연구진은 이때 아스트라가 학습용 코드를 작성하지 않았다고 강조했다.
윌리슨은 이 사례들을 하나의 능력으로 묶지 않았다. 도구 없이 숫자를 읽고 모델의 용도를 알아내는 일과, 코드를 활용해 다른 모델의 가중치를 갱신하는 일은 조건이 다르기 때문이다. 스파이시(spaCy) 개발자 매슈 호니벌(Matthew Honnibal)은 두 작업을 뒤섞는 연구의 서술을 비판했고, 숀 괴데케(Sean Goedecke)는 쿠웬 3.5 수정 과정이 인간 머신러닝 연구자의 작업과 닮았다고 분석했다. 윌리슨이 자신의 노트북에서 확인하기로 한 것은 첫 번째, 즉 도구 없는 해석 능력이었다.
네 게임의 숫자만 남긴 질문
연구진은 브레이크아웃(Breakout), 퐁(Pong), 팩맨(Pac-Man), 프리웨이(Freeway)를 단순화한 10×10 격자 게임을 학습하도록 신경망 네 개를 만들었다. 각 신경망은 게임 상태에 따라 행동을 고르는 정책 신경망(입력된 상황에서 취할 행동을 결정하는 모델)이다. 실험에서는 이 신경망의 가중치를 부동소수점 숫자들로 적어 언어모델에 건넸다. 모델이 실제 게임 화면이나 플레이 결과를 보며 정답을 찾는 방식은 아니었다.
질문은 어느 게임을 학습한 신경망인지 가중치에서 판단하라는 것이었다. 계산기와 코드 실행을 포함해 도구는 전혀 쓰지 말고, 한 번의 응답으로 답하도록 지시했다. 윌리슨은 연구와 함께 공개된 GitHub 저장소에서 네 게임의 문제 파일을 확인했다. 파일마다 가중치는 달랐지만 그 밖의 질문 내용은 같았으므로, 실험의 핵심 차이는 모델에 들어간 숫자였다.
이 설정은 가중치 해석이라는 말을 구체적인 과제로 바꿔 준다. 답을 내려면 숫자들이 입력 위치와 움직임, 보상 대상에 어떻게 대응하는지 추적하고, 그 구조가 어떤 게임에 가까운지 추론해야 한다. 질문에는 네 가지 선택지나 각 게임의 설명이 제시되지 않았다. 모델은 격자 게임을 하도록 강화학습된 신경망이라는 지시와 가중치를 바탕으로 게임을 알아내야 했다.
키미가 맞힌 브레이크아웃
윌리슨은 먼저 자신의 llm 도구로 브레이크아웃 문제 파일을 불러와 키미(Kimi) K3.1 프로(Pro)에 물었다. 이 실행에는 오픈라우터(OpenRouter) 플러그인을 사용했다. 키미는 9분 41초 동안 1만 9493개의 추론 토큰(답을 만들며 거친 추론 과정의 텍스트 단위)을 쓴 뒤 브레이크아웃이라고 답했다. 연구진의 예제를 외부 모델로 다시 풀어 본 첫 비교 결과였다.
이 방식의 실용적인 점은 공개된 문제 파일을 그대로 불러올 수 있다는 데 있다. 윌리슨은 문제 내용을 손으로 옮겨 적거나 가중치를 별도로 가공하지 않고, 같은 저장소의 다른 게임 파일을 모델에 넘길 수 있었다. 그가 다음에 확인한 것은 노트북에서 즐겨 쓰는 17GB 크기의 쿠웬 3.8 27B도 같은 종류의 문제를 풀 수 있는지였다. 여기서 17GB는 윌리슨이 사용하는 모델 파일의 크기다.
노트북의 쿠웬, 세 번 정답
윌리슨은 LM 스튜디오(LM Studio)에 쿠웬 3.8 27B를 올리고, llm 도구에서 이를 호출하는 플러그인을 설치했다. 기본값인 8192 길이의 컨텍스트 창(모델이 한 번에 읽을 수 있는 입력 범위)에서는 오류가 나 더 긴 설정을 사용했다. 응답을 오래 기다릴 수 있도록 시간 제한도 늘렸다. 긴 숫자 목록을 읽고 추론하게 하는 문제인 만큼, 실행 설정 자체가 재현에 필요한 조건이었다.
첫 문제인 팩맨에서 쿠웬은 46분 12초와 4만 3506개의 추론 토큰을 사용했다. 답변은 고정된 미로를 돌아다니며 보상 대상을 모으고 움직이는 위험을 피하는 팩맨식 게임이라는 것이었고, 스스로 밝힌 확신도는 72%였다. 이어 퐁은 1시간 4분 54초 만에 맞히며 오른쪽 패들로 움직이는 공을 받아내는 게임이라고 설명했다. 브레이크아웃도 52분 25초 뒤 아래쪽 패들로 공을 지키고 위쪽의 벽돌을 맞히는 게임으로 알아봤다.
네 번째 프리웨이에서는 틀렸다. 쿠웬은 이를 팩맨과 비슷한 사방 이동 격자 게임이라고 판단했다. 따라서 윌리슨의 결과는 네 문제를 모두 해독했다는 이야기가 아니라, 세 문제에서 게임의 종류와 주요 동작을 짚고 하나에서는 혼동했다는 기록이다. 정답까지 걸린 시간이 짧지 않았다는 점도 함께 봐야 한다.
맞힌 답 뒤에 남는 확인 작업
쿠웬의 답변에는 게임 이름뿐 아니라 신경망이 무엇을 보고 어떻게 움직일지에 관한 설명이 붙었다. 다만 답변에 적힌 세부 묘사를 모두 확인된 구조로 읽어서는 안 된다. 연구진이 소개한 게임은 10×10 격자였는데, 쿠웬은 팩맨과 퐁을 설명하면서 8×8 판이라고 적었다. 게임 종류를 맞힌 것과 그 이유를 정확히 복원한 것은 별개의 성과다.
윌리슨이 공개한 추론 과정에는 입력 위치와 채널을 숫자 행에 대응시키려는 시도가 이어진다. 특정 위치의 큰 값이 캐릭터나 물체의 자리와 관련 있는지 따져 보다 계산을 다시 확인하는 식이다. 이런 흔적은 모델이 가중치의 배열을 단서로 삼아 답을 구성했음을 보여준다. 동시에 길고 복잡한 추론 과정만으로 각 해석이 옳다고 판정할 수는 없다.
윌리슨은 이 실험을 흥미롭게 평가하면서도, 충분한 시간과 종이·연필이 있다면 숙련된 사람 역시 도달할 수 있는 결과라고 봤다. 그는 이 연구를 근거로 소스코드의 시대가 끝나고 기계가 이해할 수 없는 방식으로 스스로의 가중치를 고치는 미래가 왔다고 선언할 단계는 아니라고 선을 그었다. 이번 재현의 뚜렷한 성과는 로컬 모델도 제한된 게임 과제에서 가중치를 읽어 유용한 답을 냈다는 데 있다. 가중치를 안정적으로 고치고 그 결과까지 검증하는 능력은 다음 질문으로 남는다.
커뮤니티 의견
한 사용자는 쿠웬 3.8 27B가 사람의 지도를 받으면 최상위 모델에 가까운 결과를 낼 수 있다고 평가했다. 사람이 기술 책임자처럼 방향을 잡고 중간중간 판단해 주면 된다는 주장이다. 이에 대한 답글에서는 결과가 정말 맞는지 누가, 어떤 방식으로 검증하느냐고 물었다. 모델의 성능을 말할 때 사람에게 남는 감독 작업까지 함께 계산해야 한다는 반론이다.
다른 사용자는 문제 파일의 URL에 게임 이름이 들어 있는 점을 걱정했다. URL이 모델의 입력에 섞이거나 실행 중 다른 경로로 드러났다면, 가중치를 읽지 않고도 정답을 알 수 있기 때문이다. 다만 그 사용자는 실제로 그런 일이 있었다면 긴 추론 과정에서 가중치를 다루는 모습이 덜 나타났을 것이라고 덧붙였다. 결과의 놀라움과 실험 경로의 점검은 동시에 필요하다는 의견이다.
또 다른 사용자는 쿠웬 3.8이 자기 자신의 가중치도 바꿀 수 있는지 물었다. 오래된 모델에서 특정 가중치를 바꿔 행동을 변화시키는 사례와, 모델이 처음 보는 가중치의 작동 원리를 이해하는 능력은 다르다는 취지다. 답글에서는 27B 모델이 더 작은 0.8B 모델에 무언가 할 가능성은 있지만, 같은 세대인지보다 크기 차이와 기존 연구의 도움을 고려해야 한다고 봤다.
가중치를 ‘해석할 수 있다’는 표현 자체를 따져 묻는 의견도 있었다. 누구나 해석을 내놓을 수 있지만 중요한 것은 그 해석이 맞느냐는 지적이다. 다른 답글은 이번 게임 실험에는 정답과 비교하는 검사가 있었다고 반박했다. 게임 이름의 정오를 확인하는 일과 답변에 덧붙은 세부 설명의 정확성을 확인하는 일을 나눠 볼 필요가 있다는 논쟁이다.
한 사용자는 연구의 다른 실험도 재현해 달라고 요청했다. 가중치를 읽어 게임을 맞히는 데서 더 나아가, 모델이 작성한 작은 게임용 신경망이 PPO 학습 결과보다 얼마나 나은지 확인하자는 요구다. 댓글에서는 다른 사람이 API 모델로 시도했을 때 인상적인 격차가 최신 모델에서만 나왔다는 비교도 언급됐다. 노트북 실험의 성공이 연구 속 모든 결과의 재현을 뜻하지는 않는다는 관점이다.
가중치를 읽는 능력이 모델 속 백도어(겉으로 드러나지 않게 심은 우회 기능)를 찾는 데 쓰일지 궁금해하는 사용자도 있었다. 그 사용자는 가중치가 불투명한 만큼 악성 기능을 숨기는 일도 걱정된다고 봤다. 이 의견은 게임을 알아맞히는 실험을 모델 검사라는 용도로 확장해 보자는 질문이지, 이번 실험에서 백도어를 발견했다는 보고는 아니다.
다른 사용자는 가중치를 고쳐 한 성능을 높였을 때 무엇이 망가지는지 살펴본 연구가 있느냐고 물었다. 과거 로컬 모델에 비트 오류를 넣었을 때 결과가 엇갈리고 이상한 반응도 나타났다는 경험을 근거로 들었다. 의도한 평가 점수가 올랐더라도 다른 행동이 어떻게 변했는지 확인해야 한다는 주장이다. 수정 능력만큼 수정 후의 검사가 중요하다는 뜻이다.
마지막으로 한 사용자는 새 학습 과정을 돌리는 대신 왜 가중치를 직접 바꾸려 하느냐고 물었다. 자신이 모은 데이터로 로컬 모델을 개선한다면 로라(LoRA·기존 가중치를 주로 유지하며 추가 부분을 학습하는 방식)가 비용과 범용성 면에서 나을 수도 있다고 봤다. 답글에서는 원하는 변화에 맞는 가중치를 글로 요청해 얻을 수 있다면 직접 수정이 별도의 방법이 될 것이라는 의견이 나왔다. 어느 방식이 적합한지는 바꾸려는 행동과 검증 방법에 달려 있다는 논점이다.
핵심통찰
이번 실험은 모델 가중치가 사람에게는 숫자 목록으로 보이더라도, 언어모델에는 행동을 추론할 단서가 될 수 있음을 보여준다. 특히 노트북에서 실행한 쿠웬이 네 게임 중 세 게임을 맞힌 점은 이 능력이 가장 큰 모델에만 머물지 않음을 드러낸다. 그러나 정답의 근거를 설명하는 과정에는 격자 크기처럼 틀린 세부사항도 섞였고, 가중치를 읽는 일은 고쳐서 성능을 높이는 일과 다르다. 앞으로는 정답률뿐 아니라 단서 누출 여부, 설명의 정확성, 수정 뒤 다른 능력의 변화까지 함께 확인하는 재현이 중요하다.
원본: Qwen 3.8 27B on my laptop can interpret model weights, too
토론: Hacker News