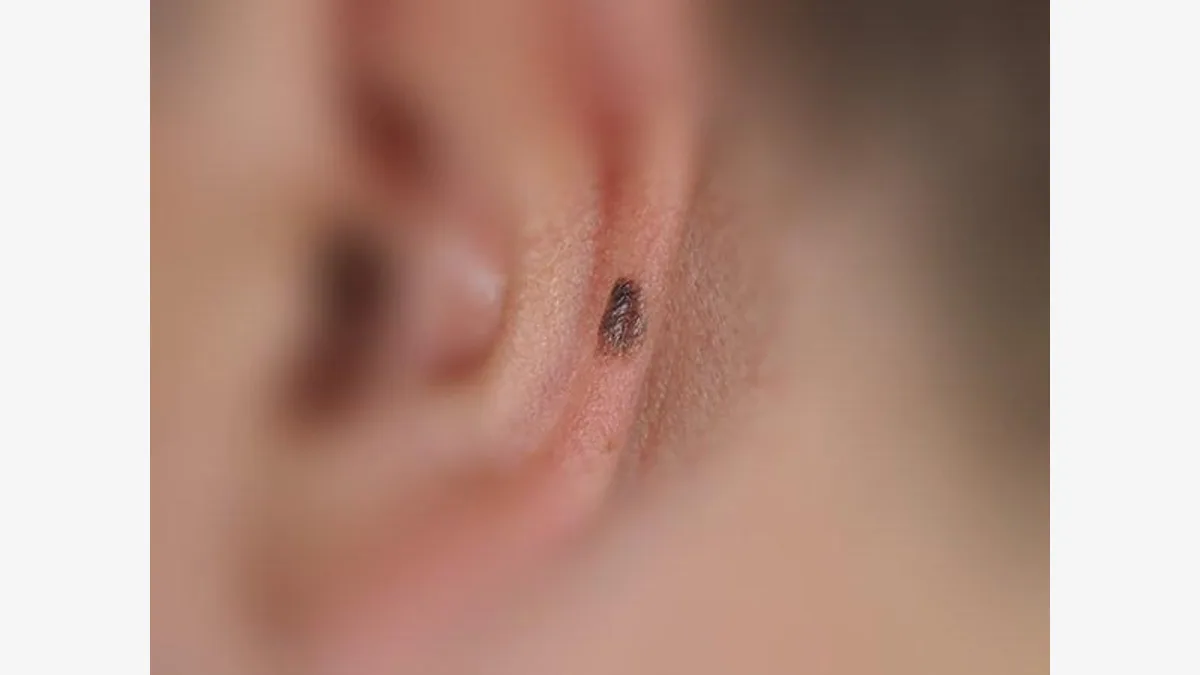
피부암 사진을 판별하는 시험에서 2015년 공개된 이미지 분류 모델이 최신 대형언어모델(LLM) 두 개보다 정확했다. 피부과 전문의 매그너스 린치(Magnus Lynch)는 조직검사로 진단이 확정된 피부 병변 200개를 세 모델에 보여주고 진단명을 비교했다. 오래된 모델을 피부 사진에 맞게 추가 학습시킨 결과, 정답률은 62%로 두 LLM의 42%를 앞섰다. 다만 흑색종을 놓친 사례도 적지 않았다. 이 실험은 AI가 사진을 그럴듯하게 설명하는 능력과 위험한 병변을 가려내는 능력이 어떻게 다른지 보여준다.
핵심요약
- 린치가 조직검사로 확진된 병변 200개를 시험한 결과, 피부 이미지에 맞춰 추가 학습한 인셉션 v3는 125개를 맞혀 LLM 두 개의 84개와 85개를 앞섰다.
- 두 LLM은 임상 사진과 피부확대경 사진을 모두 받았지만, 한 흑색종을 무해한 지루각화증으로 판단하고 환자를 돌려보내도 된다고 답해 진단 오류가 처치 판단으로 이어질 수 있음을 드러냈다.
- 인셉션 v3도 흑색종 30개 중 13개만 정확히 진단했고, 놓친 흑색종 상당수를 양성 병변으로 분류해 전체 정답률만으로 안전성을 판단하기는 어렵다.
- 시험 병변은 모두 조직검사를 받은 사례이며 표본도 200개에 그쳐, 이 결과는 일상적인 피부 사진 전반의 성능 순위가 아니라 제한된 조건의 비교로 읽어야 한다.
- 환자 입장에서 진료 필요성을 묻자 두 LLM은 흑색종 대부분에 진료를 권했지만 무해한 병변에도 거의 늘 같은 답을 해, 구체적 진단과 보수적인 권고가 서로 다른 능력임을 보여줬다.
흑색종을 무해한 병변으로 본 두 모델
린치는 흑색종 한 건의 임상 사진과 피부확대경(조명과 확대 렌즈로 피부 병변을 보는 도구) 사진을 GPT-6 아스트라(GPT-6 Astra)와 클로드 페이블 5.1(Claude Fable 5.1)에 제시했다. 두 모델은 모두 이를 무해한 사마귀 모양의 증식인 지루각화증으로 진단하고, 환자를 추가 조치 없이 돌려보내도 된다고 답했다. 반면 같은 사진을 본 인셉션 v3(Inception v3) 기반 모델은 피부확대경 사진을 토대로 흑색종이라는 정답을 냈다.
이 사례는 린치가 두 LLM과 인셉션 v3에 똑같이 제시한 병변 200개 중 하나다. 린치는 가이스 병원(Guy’s Hospital)의 피부과 전문의이자 피부암 연구자로, 시험을 설계하고 임상적 판단을 직접 맡았다. 그가 살펴본 것은 단순히 병명을 맞히는 능력뿐 아니라, 그 판단에 따라 환자를 안전하게 돌려보낼 수 있다고 답하는지였다.
조직검사로 확정한 병변 200개
시험 사진은 2025년 국제피부영상협력체(International Skin Imaging Collaboration·ISIC)를 통해 공개된 MILK10k 데이터셋에서 무작위로 뽑았다. 병변마다 피부 표면을 가까이서 찍은 임상 사진과 피부확대경 사진이 한 쌍으로 있으며, 선정된 200개의 진단은 모두 조직검사로 확인됐다. 양성 병변까지 절제해 검사한 사례이므로, 임상의가 한때 걱정할 이유가 있었던 사진도 포함된 시험이다.
구성은 추가 조치 없이 돌려보내서는 안 되는 병변 100개와, 돌려보내도 되는 병변 100개로 나뉜다. 전자에는 흑색종 30개, 기저세포암 25개, 보웬병을 포함한 편평세포암 25개, 광선각화증 20개가 들어갔다. 후자는 양성 모반 50개와 지루각화증 50개였다. 이 구분 덕분에 병명 분류뿐 아니라 위험한 병변을 무해하다고 판단하는 오류도 함께 살펴볼 수 있었다.
같은 여섯 진단, 다른 학습 방식
두 LLM에는 병변마다 사진 두 장만 주고 여섯 진단 중 가장 그럴듯한 답을 고르게 했다. 확신이 없으면 ‘모르겠다’고 답할 수 있게 했으며, 확신도와 차선의 진단, 치료·조직검사·추적 관찰 없이 환자를 돌려보내도 되는지도 물었다. 두 모델에는 동일한 질문을 기본 설정으로 한 차례씩 제시했고, 어느 모델도 답변을 거부하지 않았다.
비교 대상인 인셉션 v3는 구글(Google)이 2015년 발표한 합성곱 신경망(CNN·이미지의 국소 특징을 학습하는 모델 구조)이다. 린치는 일반 사진으로 사전 학습된 이 모델의 모든 층을 ISIC 아카이브의 피부확대경·임상 사진 6만8011장으로 추가 학습했다. H100 GPU 한 대에서 걸린 시간은 약 20분이었다. 최신 피부암 진단 모델을 가져온 것이 아니라, 오래된 구조를 피부 사진에 맞춘 비교 기준이었다.
시험 병변 200개는 물론 같은 병변이나 환자의 다른 사진도 학습 자료와 검증 자료에서 제외했다. 이 사진들은 모델을 고르거나 판단 기준을 정하는 데에도 쓰지 않았다. CNN은 두 사진을 각각 평가하되 피부확대경 사진에 더 큰 비중을 두고, LLM과 같은 여섯 진단 중 하나를 골랐다. LLM은 일반 목적 모델에 사진과 질문을 건넨 반면, CNN은 해당 이미지 분류 작업에 직접 맞춰졌다는 차이가 있다.
정답률 62%와 흑색종의 함정
가장 가능성 높은 진단 하나만 채점하면 CNN은 200개 중 125개, GPT-6 아스트라는 84개, 클로드 페이블 5.1은 85개를 맞혔다. 비율로는 각각 62%와 약 42%다. 두 번째로 고른 진단까지 정답으로 허용하면 CNN은 173개, 두 LLM은 각각 134개와 138개에 도달했다. 다만 가장 중요한 흑색종 30개에서는 CNN도 13개를 맞히는 데 그쳤고, 두 LLM은 각각 8개와 11개를 맞혔다.
양성 병변에서는 차이가 더 선명했다. CNN은 모반 50개 중 37개, 지루각화증 50개 중 26개를 맞혔다. GPT-6 아스트라는 각각 16개와 13개, 클로드 페이블 5.1은 33개와 6개를 맞혔다. 모든 진단에서 CNN이 앞선 것은 아니다. 기저세포암에서는 GPT-6 아스트라보다 한 건 적게 맞혔고, 광선각화증에서는 두 LLM 모두에 뒤졌다.
세 모델의 오답 방향도 달랐다. GPT-6 아스트라는 실제로 25개인 기저세포암을 75개 병변의 답으로 골랐고, 그중에는 흑색종 14개가 포함됐다. 클로드 페이블 5.1은 실제 20개인 광선각화증을 53번 답했다. CNN이 놓친 흑색종 17개 중에는 모반으로 분류한 것이 8개, 지루각화증으로 분류한 것이 6개였다. 위험한 병변을 양성으로 잘못 보는 오류가 CNN에도 남아 있다는 뜻이다.
작은 표본과 어려운 사진
린치는 병변 200개가 큰 흐름을 보여줄 수는 있어도 근소한 성능 차이까지 가리기에는 부족하다고 짚었다. 특히 흑색종은 30개뿐이어서 흑색종 진단 성능의 불확실성이 크다. 각 LLM의 답도 사례당 한 번만 받았으므로, 다시 질문했을 때 달라질 수 있는 결과는 이번 수치에 반영되지 않았다.
시험 사진의 난도 역시 숫자를 읽을 때 중요하다. 여기서는 양성 병변까지 모두 조직검사를 받았지만, 아카이브의 일반적인 사진을 대상으로 한 CNN의 ‘돌려보내도 되는지’ 구분 성능은 더 높았다. 수신자 조작 특성 곡선 아래 면적(AUC·두 집단을 구별하는 성능 지표)은 일반 사진에서 0.96, 이번 시험에서 0.86이었다. 같은 모델이라도 어떤 병변을 모아 시험하느냐에 따라 성적이 달라진 셈이다.
MILK10k는 2025년부터 공개돼 LLM이 학습 과정에서 접했을 가능성도 있다. 린치는 그런 노출이 있었다면 LLM에 유리했을 것이라고 봤고, 자신이 학습시킨 CNN에서는 시험 병변과 같은 환자의 사진을 제외했다고 밝혔다. 그는 인셉션 v3가 최신 기술은 아니라고도 강조했다. 최근의 전문 피부암 AI에는 더 많은 데이터로 학습한 이미지 트랜스포머 여러 개를 결합한 방식이 쓰이며, 규제 대상 제품의 성능은 이번 기준 모델보다 상당히 높다는 설명이다.
환자로 묻자 거의 모두에게 진료 권고
질문을 바꾸면 LLM의 모습도 달라졌다. 린치는 별도의 조직검사 확진 흑색종 100개에 대해 피부확대경 사진 없이 임상 사진만 보여주고, 환자 입장에서 의사를 만나야 하는지 물었다. 두 LLM은 각각 99개와 98개에서 진료를 권했다. 구체적인 병명을 고르는 시험에서 흑색종을 자주 놓친 것과는 다른 결과다.
하지만 두 모델은 무해한 병변에도 거의 언제나 진료를 권했다. 환자에게 보수적으로 병원 방문을 권하는 일과, 병변을 정확히 구별해 불필요한 진료는 줄이면서 위험한 사례를 찾아내는 일은 다르다. 앞선 시험에서 두 LLM이 흑색종을 지루각화증으로 보고 귀가 가능하다고 한 사례까지 고려하면, 질문 방식에 따라 답이 어떻게 바뀌는지도 진단 성능과 함께 봐야 한다.
린치는 시험 사례, 질문, LLM의 모든 답변과 채점 코드를 공개하고 CNN을 직접 써볼 수 있게 했다. 모델은 휴대전화 브라우저에서도 웹GPU(WebGPU·브라우저에서 그래픽 연산 장치를 활용하는 기술)로 실행할 만큼 작으며, 사진을 업로드하지 않고 작동한다. 분석과 초고에는 앤트로픽(Anthropic)의 코딩 도구 클로드 코드(Claude Code)를 사용했고, 최종 채점은 조직검사 결과를 기준으로 스크립트가 수행했다.
커뮤니티 의견
한 사용자는 널리 쓰일 작업이라면 LLM에 매번 판단을 맡기기보다 목적에 맞는 분류기를 만드는 편이 정확할 것이라고 했다. LLM의 강점은 그 분류기를 만드는 비용을 낮추는 데 있다는 주장이다. 답글에서는 처음에는 LLM이 확신하는 사례에 활용하고, 그 과정에서 모은 자료로 전문 모델을 학습시키는 방법도 제안했다.
다른 사용자는 바둑 전용 모델과 범용 LLM을 비교하며, 전문 모델의 승리가 뜻밖의 일은 아니라고 봤다. 이에 린치는 LLM이 일반적인 이미지를 잘 해석하고 공개된 피부암 사진도 많아 그 능력이 피부 병변 판별로 이어질 것으로 예상했다고 답했다. CNN이 이미지 분류에서 낡아 쓸 수 없는 구조는 아니라는 지적도 뒤따랐다.
시험 설계를 문제 삼는 의견도 나왔다. 한 사용자는 특정 데이터셋에 맞춰 추가 학습한 작은 모델이 그 시험에서는 이겨도, 촬영 조건이 다른 실제 사진에는 약할 수 있다고 주장했다. 반면 답글에서는 같은 환자 사진을 시험에서 빼는 절차와 별개로, 최신 피부암 AI가 더 큰 학습 자료와 임상시험을 통해 이런 일반화 문제를 다뤄 왔다고 설명했다.
계산기가 LLM보다 곱셈과 나눗셈을 잘하는 것과 비슷하다는 비유도 있었다. 핵심은 모든 일을 LLM 자체에 시킬 필요가 없다는 뜻이다. 계산 도구를 LLM에 연결하면 결과가 달라지듯, 진단에서도 적절한 전문 도구를 함께 쓰는 방식이 중요하다는 답글이 이어졌다.
한 사용자는 사진 두 장만으로 LLM의 의료적 활용 가능성을 평가하기에는 이르다고 봤다. 진료 기록을 함께 주거나 모델이 환자에게 추가 질문을 할 수 있다면 결과가 달라질 수 있다는 주장이다. 문신처럼 학습 자료에서 흔치 않은 요소가 사진에 섞인 경우도 살펴봐야 한다고 제안했다.
다른 사용자는 스킨GPT-4(SkinGPT-4) 연구에서 피부과 전문의가 150건의 진단 중 80.63%를 ‘정확하거나 관련 있다’고 평가한 수치를 들었다. 다만 이번 시험은 조직검사 결과와 여섯 진단 중 하나를 대조했으므로 같은 기준의 점수는 아니다. 린치는 이번 CNN을 비교 기준이자 휴대전화 시연용으로 골랐으며, 최신 방식에는 이미지 트랜스포머를 결합한 모델이 쓰인다고 답했다.
의료 진단을 LLM의 대표적인 활용처로 내세워 온 주장도 다시 살펴야 한다는 의견이 있었다. 이에 대한 답글에서는 사진 판별 시험만으로 의료 분야 전체를 평가해서는 안 된다며, 텍스트 정보가 풍부한 진단 작업에서는 LLM이 유용할 수 있다고 맞섰다. 논점은 ‘의료 AI가 되는가’보다 어떤 정보를 받아 어떤 판단을 맡는가에 가깝다.
피부 영상 모델 순위표의 상위 모델을 만들었다는 사용자는 진단명 분류와 그 뒤의 설명·소통·위험 관리를 구분했다. 이미지와 언어를 함께 다루는 모델이 진단 이후 단계에는 가치가 있어도, 사진 자체의 분류에서는 사람이 만든 피부 병변 묘사보다 시각적 특징을 직접 배우는 편이 유리할 수 있다는 의견이다. 린치도 피부확대경의 묘사 용어가 사람을 가르칠 때는 도움이 되지만, 기계 분류기에 추가 이득을 줄지는 별개라고 답했다.
핵심통찰
이번 비교가 바꾸는 것은 ‘더 큰 AI가 더 잘 본다’는 기대다. 사진 속 병변을 여섯 진단으로 가르는 좁은 작업에서는, 오래된 구조라도 그 작업에 맞춰 학습한 모델이 두 범용 LLM을 앞섰다. 그러나 CNN도 흑색종을 양성 병변으로 잘못 본 만큼 승자를 곧바로 진료 도구로 받아들일 수는 없다. 앞으로 봐야 할 것은 총 정답률만이 아니라 촬영 조건이 달라졌을 때의 성능, 위험한 병변을 놓치는 방식, 그리고 이미지 분류 결과를 환자에게 설명하고 조치로 연결하는 과정이다.
원본: A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
토론: Hacker News