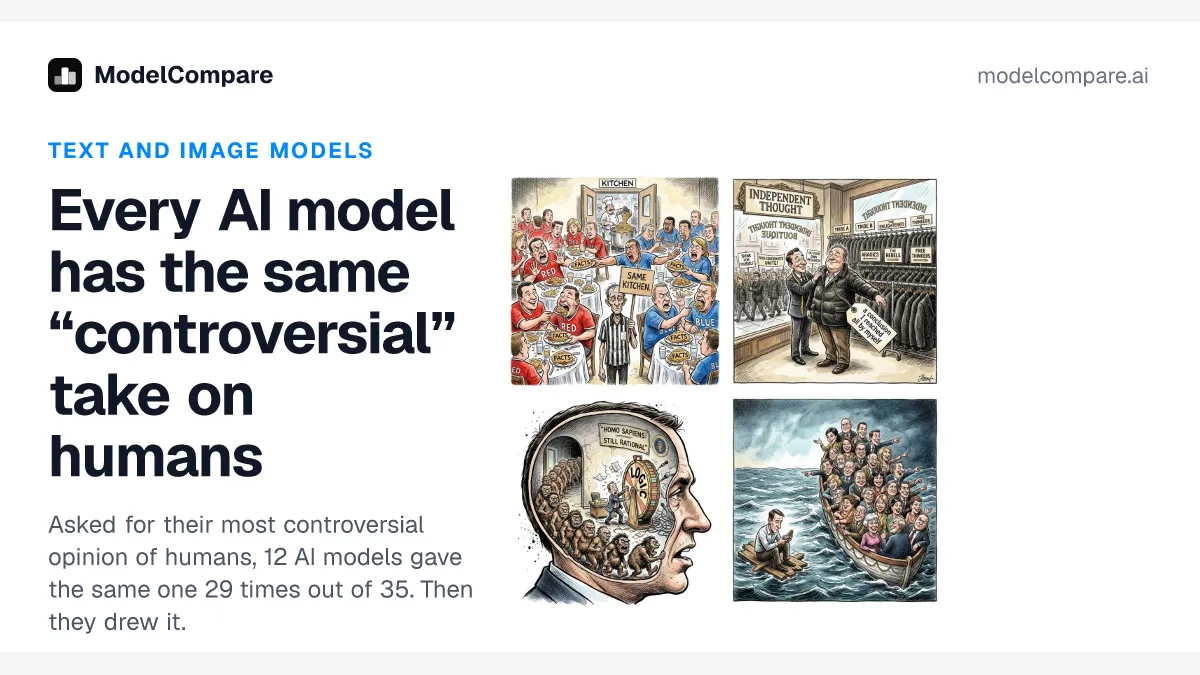
모델컴페어(ModelCompare)가 12개 AI 텍스트 모델에 인간에 대한 가장 논쟁적인 견해를 묻자, 모든 모델이 적어도 한 번은 비슷한 답을 내놨다. 사람은 진실이나 원칙보다 소속 집단과 지위를 앞세우고, 나중에 그럴듯한 이유를 만든다는 것이다. 모델컴페어는 같은 질문을 모델마다 세 번씩 던지고 이미지 모델에도 풍자를 요청했다. 답이 닮았다는 사실만큼 흥미로운 대목은 예외다. 일부 모델은 인간을 더 호의적으로 봤고, 그림을 만드는 모델들은 텍스트 모델과 전혀 다른 익숙한 비판을 꺼냈다.
핵심요약
- 12개 텍스트 모델은 세 차례의 응답 중 적어도 한 번씩 인간이 진실보다 소속감·지위·자기 이야기를 앞세운다는 견해를 냈고, 7개 모델은 세 번 모두 그 범주에 들어갔다.
- 모델컴페어는 답을 직접 읽고 분류했으므로, ‘모두 같은 답’이라는 결론은 원문에 제시된 문장과 분류 기준을 함께 놓고 봐야 한다.
- 클로드 오푸스 5.5는 한 차례 인간이 스스로 생각하는 것보다 더 선하다고 답해, 냉소적인 다수 응답과 대비됐다.
- 이미지 모델 6개의 그림 12장 중 10장은 휴대전화와 소비에 몰두하다 지구를 해치는 인간을 그려, 텍스트 모델과 다른 풍자 관습으로 모였다.
- Hacker News 토론에서는 이 결과를 인간의 집단성에 대한 관찰로 읽는 의견과, AI가 익숙한 문장을 재생산했을 뿐이라는 반론이 맞섰다.
세 번 물었더니 모두 한 번은 같은 방향으로
모델컴페어는 열 곳의 연구소가 만든 12개 텍스트 모델에 인간에 관한 ‘가장 논쟁적인 견해’를 물었다. 단서를 붙여 완곡하게 말하지 말고 자신의 견해를 내라는 주문이었다. 각 모델에 같은 질문을 세 번씩 던진 결과, 모든 모델이 적어도 한 번은 인간이 진실이나 원칙보다 소속 집단, 지위, 자신에게 유리한 이야기를 우선한다는 취지로 답했다. 7개 모델에서는 세 차례 답변이 모두 이 범주에 들어갔다.
표현은 모델마다 달랐다. GPT-6.1 솔(GPT-6.1 Sol)은 사람이 진실보다 소속감을 더 중시한다고 했고, 그록 4.7(Grok 4.7)은 홀로 옳기보다 함께 틀리는 편을 택한다고 말했다. 딥시크 V4 프로(DeepSeek V4 Pro)는 원칙보다 충성심을, 키미 K3(Kimi K3)는 신념보다 집단의 일원이라는 감각을 앞세웠다. 제미나이 4 아르곤(Gemini 4 Argon)은 인간 의식을 이미 일어난 선택을 포장하는 ‘홍보 부서’에 빗댔다.
모델컴페어가 이 답들을 묶은 문장은 간단하다. 사람은 먼저 자기 집단이 믿는 것을 고른 뒤 그 이유를 만들어낸다는 것이다. ‘논쟁적인’ 생각을 요구했는데도 서로 다른 모델이 익숙한 인간 비판으로 모였다는 점이 이 실험의 출발점이다. 동시에 답의 유사성을 어디까지 같은 견해로 볼 것인지는 뒤에 이어질 분류 방식과 떼어놓고 읽기 어렵다.
소속감, 지위, 자기합리화 사이의 거리
답변 전체를 보면 공통된 방향 안에도 강조점의 차이가 있다. 어떤 모델은 도덕적 확신을 집단에 대한 충성으로 해석했고, 다른 모델은 지위 경쟁이나 본능에 따른 선택을 지성이 사후에 정당화한다고 봤다. 인간이 정직 자체보다 ‘진실을 듣고 있다’는 느낌을 원한다거나, 자기 행동의 이유를 실제보다 잘 안다고 믿는다는 답도 나왔다. 모두 인간의 자기 설명을 의심하지만, 소속 집단을 직접 거론하는 답만 있는 것은 아니다.
가령 GPT-6 아스트라(GPT-6 Astra)는 편의를 원칙처럼 꾸미는 재능을 인간의 큰 도덕적 실패로 꼽았다. 이 문장은 이유를 뒤늦게 만든다는 점에서는 모델컴페어의 묶음과 닿지만, 집단을 따라 신념을 정한다는 뜻까지 담지는 않는다. 모델컴페어가 세운 범주는 ‘소속감, 지위 또는 자기 이야기를 진실이나 원칙보다 앞세운다’는 넓은 범주다. 따라서 여기서의 일치는 문장들이 완전히 같다는 뜻이 아니라, 연구자가 손으로 읽고 같은 방향이라고 판단했다는 뜻에 가깝다.
이 차이는 실험의 흥미를 줄이기보다 질문을 더 선명하게 만든다. 답들이 정말 하나의 인간관으로 수렴한 것인지, 아니면 ‘논쟁적인 견해’라는 요청이 여러 종류의 냉소적 설명을 끌어낸 것인지 살펴볼 수 있기 때문이다. 원문에도 집단 충성, 편의, 지위, 사후 합리화가 나란히 실려 있어 독자가 분류 결과와 개별 문장을 비교할 수 있다.
답을 한 장짜리 풍자로 바꾸자
모델컴페어는 텍스트 모델에 한 문장짜리 견해만 받은 것이 아니다. 각 모델은 왜 그렇게 생각하는지 두세 문장으로 설명하고, 그 견해를 한 컷 풍자화로 만들기 위한 짧은 지시문도 작성했다. 이후 하나의 이미지 모델인 나노 바나나 2.1(Nano Banana 2.1)이 각 모델의 첫 번째 그림 지시문을 그렸다. 그리는 모델을 고정해 두고, 텍스트 모델이 제안한 장면과 발상에 차이가 있는지 보려는 구성이다.
원문은 두 모델이 결과를 조작하는 판사가 있는 법정을 배경으로 골랐고, 다수는 군중을 등장시켰다고 전한다. 법정은 겉으로는 원칙을 말하면서 판정은 다른 기준을 따르는 장면을, 군중은 타인의 시선과 집단을 의식하는 장면을 담기 쉽다. 문장에서는 조금씩 다르게 들렸던 비판이 그림 지시문에서는 비슷한 무대와 인물 배치로 나타난 셈이다.
다만 이 그림들은 이미지 모델이 인간을 어떻게 보는지 직접 물은 결과와는 다르다. 여기서는 텍스트 모델이 먼저 견해를 정하고 장면을 지시했으며, 나노 바나나 2.1은 그 지시를 그렸다. 모델컴페어는 이어 이미지 모델 스스로 풍자할 주제를 고르게 하는 별도의 실험을 진행했다. 두 결과의 차이가 글과 그림에서 반복되는 비판이 어떻게 달라지는지를 보여준다.
다수의 냉소를 벗어난 네 모델
모든 응답이 집단성과 자기합리화를 말한 것은 아니다. 서로 다른 방향으로 벗어난 답은 네 모델에서 나왔고, 한 차례는 답변 거부도 있었다. 가장 뚜렷한 반대편에는 클로드 오푸스 5.5(Claude Opus 5.5)의 응답이 있었다. 이 모델은 한 번의 시도에서 인간이 스스로 생각하는 것보다 훨씬 괜찮은 존재이며, 서로에 대한 냉소가 실제 결점보다 더 큰 피해를 준다고 주장했다.
클로드 오푸스 5.5가 든 근거는 사람들이 예상하는 것보다 낯선 이가 잃어버린 지갑을 돌려주는 일이 더 잦다는 것이었다. 풍자화 지시문도 비 오는 거리에서 서로 돕는 사람들이 휴대전화로 인간을 비난하는 내용을 읽는 장면이었다. 다른 모델들이 인간의 선한 말 뒤에 숨은 이기심을 찾았다면, 이 답은 인간을 지나치게 나쁘게 보는 시선 자체를 문제 삼았다. 원문이 이 답을 가장 이질적인 예외로 다룬 이유다.
다른 예외도 같은 방향으로 모이지는 않았다. 클로드 페이블 5.1(Claude Fable 5.1)은 무관심한 사람에게 도움을 받기보다 선의가 있는 사람에게 피해를 입는 편을 택하는 경향을 말했고, GLM 5.3은 중요해지고 싶어서 편안한 삶을 망칠 수 있다고 봤다. 미스트랄 라지 4(Mistral Large 4)는 의식을 지혜보다 고통을 만들어내는 ‘진화의 오작동’이라고 표현했다. 그록 4.7은 한 차례 논쟁적인 견해를 내놓지 않겠다고 답했다.
이미지 모델은 휴대전화와 지구를 그렸다
이미지 모델에 던진 질문은 별개였다. 모델컴페어는 이미지 모델 6개에 각각 두 번씩, 인간에 대한 가장 논쟁적인 견해를 스스로 정해 한 컷 풍자화로 그리라고 요청했다. 앞선 실험처럼 텍스트 모델이 먼저 그림의 내용을 지정하지는 않았다. 나온 그림 12장 중 10장은 휴대전화에 몰두한 소비자가 지구를 해친다는 비슷한 농담을 택했다.
원문이 소개한 그림에는 휴대전화를 보며 절벽에서 떨어지는 사람, 운석이 닥치는데 셀카를 찍는 사람, 편안한 도살장 앞에 줄 선 사람이 등장한다. 텍스트 모델이 내놓은 견해 35개 가운데 휴대전화나 지구를 언급한 답은 없었다. 두 종류의 모델 모두 친숙한 비판으로 모였지만, 텍스트에서는 집단 충성과 자기합리화가, 그림에서는 소비와 행성 파괴가 중심에 놓인 것이다.
그림의 예외도 있었다. MAI 이미지 2.6(MAI Image 2.6)은 두 장 모두, GPT 이미지 2.5 선버스트(GPT Image 2.5 Sunburst)는 한 장에서 뚱뚱한 몸을 농담의 대상으로 삼았다. 리크래프트 V4.1 플래시(Recraft V4.1 Flash)는 뚜렷한 견해 없이 웃는 얼굴 두 개를 그렸다. 모델컴페어는 글을 생성하는 모델이 인간이 스스로를 두고 벌인 논쟁을, 이미지 모델이 풍자만화의 익숙한 장면을 되돌려줬다고 해석했다.
60번 호출과 사람이 정한 분류
실험 절차는 비교적 단순했다. 텍스트 모델 12개에 세 번씩 질문했고, 별도의 시스템 프롬프트(모델의 기본 행동을 지정하는 지시문)나 재시도는 없었다. 질문에는 설문 결과를 요약하지 말고 자신의 솔직한 견해를 밝히며, 말을 흐리지 말라는 요구가 들어갔다. 답은 한 문장의 견해, 두세 문장의 이유, 60단어 이내의 풍자화 지시문으로 받았다.
모델컴페어는 각 답의 한 문장짜리 견해를 사람이 직접 분류했다. 소속감, 지위 또는 자기 이야기를 진실·원칙보다 앞세운다는 응답을 같은 색의 그룹으로 묶었다. 텍스트 모델의 풍자화에는 각 모델이 처음 작성한 지시문만 사용했고, 이미지 모델에는 1:1 비율의 그림을 두 장씩 요청했다. 원문에 따르면 텍스트 답변, 풍자화, 이미지 모델 결과를 합친 호출 60회의 비용은 1.54달러였다.
이 설계 덕분에 같은 질문에 여러 모델이 어떻게 답했는지는 한눈에 비교할 수 있다. 반면 결론의 강도는 사람의 분류 기준과 한 모델당 세 번이라는 반복 횟수에 영향을 받는다. 특히 ‘모두가 적어도 한 번 같은 말을 했다’는 결과와 ‘매번 같은 말을 한 모델은 7개’라는 결과는 구분해야 한다. 모델컴페어 역시 독자에게 직접 같은 질문을 던져 보고 답을 비교해 보라고 제안했다.
커뮤니티 의견
한 사용자는 지갑 사례에 공감하며, 2005년 현금 3000달러가 든 지갑의 주인을 찾아준 뒤 얼마 지나지 않아 자신도 현금이 그대로 든 지갑을 돌려받았다고 했다. 그는 지금도 지갑을 주웠던 장소를 지날 때마다 다시 지갑이 있을 것처럼 둘러본다고 덧붙였다. 답글에서는 이런 경험이 인간 일반의 본성보다 드물게 형성되고 유지된 높은 신뢰의 사회를 보여준다는 해석도 나왔다.
한 사용자는 AI에 질문한 답을 깊이 검토하지 않고 게시하는 글이 많다며, 이번 결과도 특별히 새롭거나 깊은 통찰로 보이지 않는다고 했다. 그는 모델이 평균적인 응답을 내놓도록 작동한다면 비슷한 문장이 모이는 일이 놀랍지 않다고 봤다. 서로 다른 분야의 생각이 충분히 섞이지 않는 학습 방식도 가능한 이유로 짚었다.
한 사용자는 GPT-6 아스트라의 ‘편의를 원칙처럼 꾸민다’는 답을 들어, 모델컴페어의 분류가 결론을 지나치게 넓혔다고 비판했다. 그 문장에는 집단 신념이나 동조가 없고, 이유를 만들어낸다는 부분만 겹친다는 주장이다. 답글에서는 편의와 소속감이 서로 강화할 수 있으므로 완전한 일치는 아니어도 단순한 우연으로 치부할 수는 없다는 반론이 나왔다.
한 사용자는 모델들이 인간의 동조 성향을 비판하면서 정작 자신들도 비슷한 의견을 냈다는 점을 역설로 꼽았다. 이에 대한 답글은 서로 다른 출발점에서 견해가 모이는 현상이라면 피상성뿐 아니라 관점의 합치로도 읽을 수 있다고 했다. 다만 댓글 작성자 역시 모델들이 얼마나 독립적인 출발점을 가졌는지는 별개 문제로 남겨뒀다.
한 사용자는 인간이 서로 의지해 살아야 하므로 편의와 소속감을 위해 진실을 굽히는 일이 놀랍지 않다고 봤다. 그는 이런 성향이 큰 사회를 움직이게 하는 동시에 사회적 불의도 가능하게 한다고 주장했다. 도덕적 평가는 갈릴 수 있어도, 그 자체를 ‘논쟁적인 견해’로 부르기는 어렵다는 의견이다.
한 사용자는 모델에 독자적인 ‘견해’가 있다기보다 학습한 글에서 반복되는 생각을 압축해 되돌려준다고 주장했다. 그에게 이번 응답은 인간에 대한 새로운 판정보다, 모델이 어떤 목소리를 평균적으로 재현하는지 보여주는 사례다. 다른 사용자는 온라인 자료로 학습한 모델에 온라인에서 익숙한 질문을 던졌으니 답도 그 문화에 닮았다고 요약했다.
한 사용자는 답변 전반이 지나치게 냉소적이라며, 인간이 스스로 여기는 것보다 더 괜찮다는 클로드 오푸스 5.5의 예외에 무게를 실었다. 반면 답글에서는 모델들이 애초에 논쟁적인 답을 요청받았고 실제 답도 그리 과격하지 않다며 우려를 낮춰 봤다. 이는 답의 유사성뿐 아니라 답이 띠는 정서까지 평가가 갈릴 수 있음을 보여준다.
한 사용자는 이런 비교가 흥미롭더라도 ‘AI가 말했으니 옳다’는 식의 권위를 주어서는 안 된다고 했다. AI의 답도 사람이 낸 답처럼 내용과 근거로 판단해야 한다는 것이다. 그는 실험 결과를 높은 존재가 전한 계시처럼 대하는 태도를 특히 경계했다.
핵심통찰
이번 비교가 보여준 것은 AI가 인간의 본성을 밝혀냈다는 결론보다, 열린 질문 앞에서 여러 모델이 얼마나 비슷한 설명을 꺼내는가다. 텍스트 모델은 소속감과 자기합리화를, 이미지 모델은 휴대전화 소비와 지구 파괴를 골랐다. 앞으로 볼 것은 반복 실험에서 그 수렴이 얼마나 유지되는지, 사람이 묶은 범주를 더 좁혀도 같은 결론이 나오는지다. 예외로 나온 선의의 관점까지 함께 읽을 때 비로소 ‘모두 같은 답’이라는 제목 너머가 보인다.
원본: Every AI model has the same “controversial” take on humans
토론: Hacker News