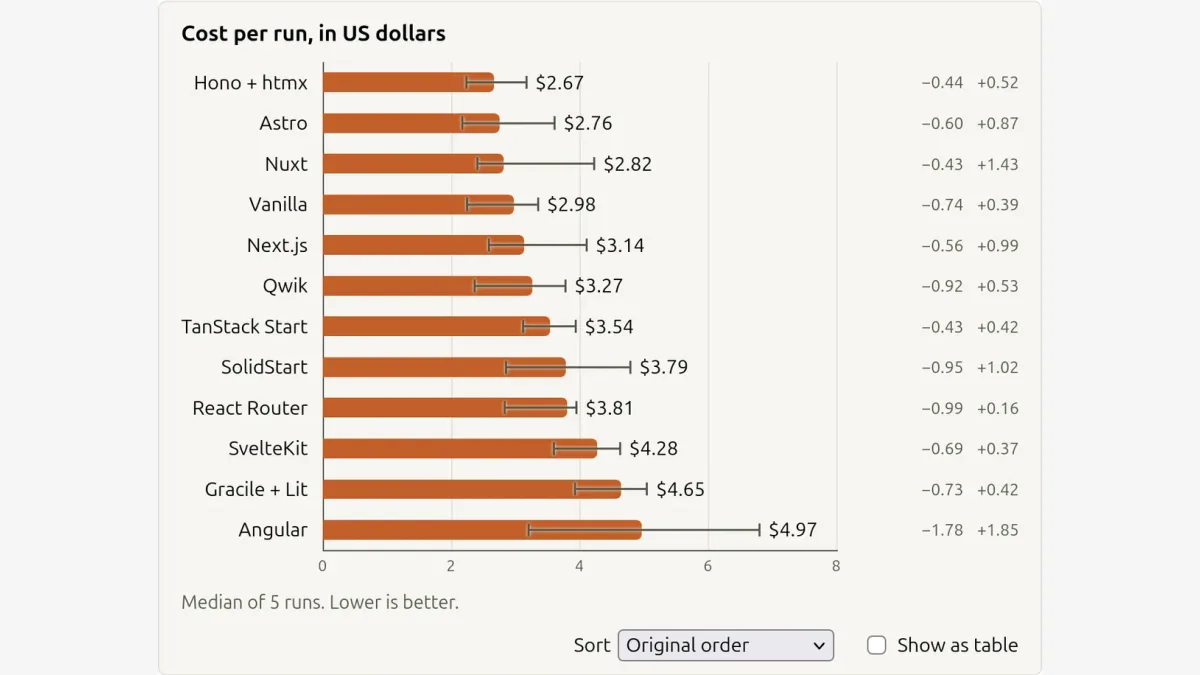
웹 개발자 놀란 로슨(Nolan Lawson)은 AI 코딩 시대의 JavaScript 프레임워크 선택에도 감이 아니라 측정이 필요하다고 주장했다. 그는 같은 포켓몬 앱을 여러 프레임워크로 각각 다섯 차례 만들게 한 뒤 개발 비용, 작업 시간, 웹 성능, 코드 길이를 비교했다. 결과는 특정 도구의 우승표보다 더 흥미롭다. 에이전트가 코드를 대신 쓰더라도 프레임워크에 익숙해지는 데 드는 토큰과 사용자가 받아 볼 페이지의 무게는 사라지지 않기 때문이다.
핵심요약
- 로슨은 동일한 앱 제작 과제를 여러 JavaScript 프레임워크에 적용해, ‘AI 에이전트에 더 좋다’는 주장을 비용과 결과물로 따져 봤다.
- 스벨트킷, 그라실+릿, 앵귤러는 상대적으로 제작 비용이 높았으며, 낯선 문서를 읽거나 더 많은 코드를 작성하는 과정이 영향을 줬다.
- 성능 점수보다 전송된 JavaScript 양과 페이지 표시 방식에서 차이가 뚜렷했지만, 콘텐츠 중심 앱이라는 시험 조건이 결과에 작용했다.
- 호노+htmx는 앵귤러보다 적은 코드로 비슷한 기능을 구현해, 생성 이후의 코드 크기도 유지보수 비용으로 봐야 한다는 질문을 던졌다.
- 토론에서는 프레임워크의 장기 유지보수 가치와 복잡한 상호작용을 다루는 능력을 이 시험만으로 판단하기 어렵다는 의견이 나왔다.
‘에이전트에 좋다’는 말 대신 시험을
로슨이 문제 삼은 것은 프레임워크 자체보다 선택의 근거다. 웹 개발 현장에서는 어떤 도구가 빠르거나 개발을 쉽게 해 준다는 주장이 측정치 없이 퍼져 왔고, AI 에이전트가 코드를 작성하는 지금도 ‘에이전트가 더 잘 다룬다’는 이유로 프런트엔드를 다시 만드는 일이 벌어진다고 그는 지적한다. 사람이 직접 코드를 입력할 때의 편의성이 덜 중요해졌다면, 에이전트가 실제로 무엇을 얼마나 잘 만드는지 확인할 이유는 오히려 커진다.
이를 위해 그는 포켓몬(Pokémon) 목록을 검색하고 필터링하며 속성, 기술, 게임별 데이터를 볼 수 있는 작은 앱을 과제로 정했다. 데이터는 포케API(PokéAPI)에서 가져오고, 결과물은 기능 명세를 지켰는지 검사한다. 이어 제작 시간과 사용 토큰, 코드 줄 수, 라이트하우스(Lighthouse)의 성능·접근성 지표를 비교하는 방식이다.
이 앱은 화면을 자주 조작하는 복잡한 서비스보다 콘텐츠를 찾아 읽는 사이트에 가깝다. 로슨도 이 한 가지 유형의 앱으로 모든 프레임워크를 재단할 수는 없다고 인정한다. 대신 과제를 이해하고 검사하기 쉬워야 프레임워크별 결과를 비교할 수 있다고 판단했다.
같은 과제, 통제하기 어려운 에이전트
각 에이전트에는 해당 프레임워크의 최신 버전을 쓰고 동일한 기능 명세를 따르라고 지시했다. 모델은 높은 작업 강도로 설정한 오퍼스(Opus) 5.5였으며, 실행 환경은 서로 분리했다. 프레임워크가 제공하는 공식 MCP(에이전트에 외부 도구와 정보를 연결하는 규약)나 스킬(작업 방법을 담은 지침)도 사용할 수 있게 했다.
반면 서버에서 HTML을 만드는 SSR(서버 측 렌더링)과 브라우저에서 화면을 구성하는 CSR(클라이언트 측 렌더링) 중 무엇을 택할지는 지정하지 않았다. 성능 점수를 높이라는 주문도 하지 않았고, 에이전트에는 라이트하우스 평가가 예정돼 있다는 사실을 알리지 않았다. CSS 선택은 일부 제한하되 시각적 일관성을 위한 디자인 기준만 줘, 시험의 중심을 JavaScript 프레임워크에 뒀다.
공식 자료를 열어 줬다고 에이전트가 반드시 읽는 것은 아니었다. 탄스택 스타트(TanStack Start)의 스킬 파일은 다섯 번 중 두 번만 발견됐고, 넉스트(Nuxt)의 MCP는 쓰이지 않았다. 넥스트.js(Next.js)에서도 스킬 파일을 읽은 실행은 한 번, 에이전트용 안내 문서를 읽은 실행은 두 번이었다. 로슨은 이런 들쭉날쭉함까지 실제 AI 코딩 과정의 일부로 봤다.
제작 비용을 키운 문서 탐색과 코드량
로슨은 원칙적으로 프레임워크마다 앱을 다섯 번 만든 뒤 중앙값을 비교했다. 표시한 비용은 클로드 코드(Claude Code)가 보고한 API 요금 기준이지, 그가 실제로 추가 지불한 금액은 아니다. 전체 작업 시간과 사용 토큰은 대체로 이 비용 흐름을 따라갔지만, 같은 프레임워크 안에서도 실행별 편차가 있었다.
상대적으로 제작 비용이 높았던 것은 스벨트킷(SvelteKit), 그라실(Gracile)+릿(Lit), 앵귤러(Angular)였다. 로슨은 스벨트킷 에이전트가 매번 스벨트킷 v3 마이그레이션 가이드를 읽은 점을 들며, 새 버전에 관한 지식이 모델에 충분하지 않았을 가능성을 제시했다. 그라실에서는 에이전트가 저장소를 복제하거나 설치된 파일의 코드를 읽었고, 앵귤러의 비용은 전체 코드량과 관련이 있어 보인다고 설명했다.
낮은 비용 순위도 한 번의 결과처럼 읽어서는 안 된다. 리액트 라우터(React Router)는 호노(Hono)+htmx보다 중앙값 기준으로 약 1달러 비쌌지만, 리액트 라우터의 가장 저렴한 실행은 호노+htmx의 가장 비싼 실행보다 쌌다. 프레임워크 없이 비트(Vite)와 순수 JavaScript 또는 TypeScript만 쓰게 한 경우도 여러 프레임워크보다 성적이 낮았다. 이 과제에서는 도구가 아예 없는 것보다 적절한 틀이 있는 편이 에이전트에 도움이 될 수 있다는 결과다.
성능 점수보다 드러난 JavaScript 전송량
완성된 앱은 기능 검사를 통과하는 것만으로 평가를 끝내지 않았다. 로슨은 사용자에게 전달되는 결과도 중요하다며 홈페이지의 라이트하우스 수치를 살폈다. 다만 이 시험에서 성능·접근성 점수와 누적 레이아웃 이동(CLS·화면 요소가 뜻밖에 밀리는 정도)은 대부분 높은 수준에 모여 있어 프레임워크별 차이를 읽기 어려웠다.
더 분명한 차이는 브라우저로 보낸 JavaScript 용량에서 나타났다. 총 차단 시간(TBT·화면의 주요 작업이 오래 막힌 시간)도 앱마다 달랐지만 수치는 전반적으로 작았다. 최대 콘텐츠 표시 시간(LCP·가장 큰 화면 요소가 표시되기까지 걸린 시간)은 측정 때마다 어떤 이미지가 대상으로 잡히는지에 따라 크게 흔들렸다.
전체적인 경향은 페이지마다 HTML을 받아 표시하는 MPA(다중 페이지 앱)에 유리했다. 브라우저가 JavaScript 실행 뒤 화면을 그리는 SPA(단일 페이지 앱)는 이 과제의 LCP에서 불리했고, 퀵(Qwik)은 클라이언트 측 이동을 쓰면서도 MPA에 가까운 성적을 낸 예외였다. 다만 로슨은 라이트하우스와 코어 웹 바이탈 지표가 SPA에 불리하며, 앱 내부의 상호작용을 측정했다면 다른 그림이 나올 수 있다고 밝혔다.
실패한 실행과 짧은 코드의 대가
에이전트가 같은 프레임워크를 항상 같은 방식으로 쓰지도 않았다. 그라실로 만든 앱 두 개에서는 릿이 아예 쓰이지 않았고, 순수 JavaScript를 허용한 경우에는 다섯 번 모두 SPA가 만들어졌다. 넥스트.js의 LCP 편차에는 한 앱만 이미지를 지연 로딩하지 않은 점이 영향을 줬다.
앵귤러에서는 다섯 번 중 두 번, 에이전트가 만든 SSR 앱이 로컬호스트가 아닌 요청을 거부했다. 앱이 리버스 프록시 뒤에서 실행된다는 지시가 있었으므로 로슨은 이를 명세 위반으로 처리하고 다시 만들지 않았다. 이 때문에 앵귤러의 코드량과 성능 비교에는 세 번의 결과만 들어갔으며, 제작 비용 비교에는 다섯 번 모두 포함됐다.
유지보수 비교에는 복잡한 지표 대신 비어 있지 않은 소스 코드 줄 수를 썼다. 호노+htmx는 앵귤러 코드량의 약 70%로 대체로 같은 기능을 구현했다. 로슨은 에이전트가 이후 수정에서도 기존 코드를 읽어야 하는 만큼, 코드 크기가 장기적으로 사용 토큰과 비용에 영향을 준다고 봤다. 짧은 코드가 곧 좋은 코드라는 뜻은 아니지만, 생성 순간의 비용만 볼 일도 아니라는 얘기다.
프레임워크 순위표보다 재현 가능한 질문
로슨은 성능을 높이는 세부 기법을 에이전트에 미리 가르치지 않았다. 반대로 포켓몬 데이터를 정적 HTML 파일로 전부 미리 만들어 과제를 우회하는 일은 금지하고 검사에도 넣었다. 그가 보고 싶었던 것은 최적화 지시를 받은 전문가의 결과보다, 명세를 받은 코딩 에이전트가 보통 어떤 앱을 만드는가였다.
시험을 넓힐 방법은 많다. 더 많은 반복 실행과 다른 에이전트·브라우저를 쓰거나, MCP 사용 여부를 나누고 상호작용이 많은 앱을 만들면 결과가 달라질 수 있다. 로슨은 벤치마크를 GitHub에 공개하면서 오류를 찾거나 다른 조건으로 시험한 결과도 받아들이겠다고 했다.
그의 결론은 어느 프레임워크가 AI 시대의 정답이라는 선언이 아니다. AI가 코드를 대신 작성한다면 개발자는 익숙해서 택해 온 도구를 다시 평가할 수 있고, 그 판단에는 제작 비용뿐 아니라 속도와 접근성, 이후 수정할 코드의 크기까지 들어가야 한다는 것이다. 에이전트에 좋다는 인상 대신 어떤 앱에서 어떤 결과가 나왔는지를 묻자는 제안이다.
커뮤니티 의견
한 사용자는 프레임워크의 비용을 토큰이나 성능보다 사람의 선택권에서 찾았다. 기업이 익숙한 프레임워크를 채택하면 교육과 채용은 쉬워질 수 있지만, 그 틀 밖의 문제를 효율적으로 풀 능력은 줄어든다는 주장이다. 답글에서는 프레임워크가 애초에 개발자를 돕기 위해 개발자들에 의해 만들어졌다는 반론이 나왔다.
다른 사용자는 프레임워크의 강점이 여러 사람이 오가는 장기 프로젝트에서 드러난다고 봤다. 무엇을 할 수 있게 해 주는가보다 위험한 구현을 막고 코드 작성 방식을 맞춰 주는 기능이 중요하다는 것이다. 그는 동시에 이번 앱은 대체로 정적인 데다 기능 간 의존성이나 컴포넌트 재사용이 적어 그 가치를 비교하기 어렵다고 지적했다.
또 다른 의견은 AI가 상태 관리를 대신 구현하더라도, 상태를 어디서 어떻게 다룰지는 여전히 설계 문제라고 짚었다. 이 사용자는 프레임워크 선택을 앱의 용도, 성능과 규모, 모델의 능력이 만나는 문제로 봤다. 현재 리액트(React)에 관한 학습 사례가 많고 개발자도 코드를 읽는 데 익숙하다는 점 역시 선택에 영향을 준다고 했다.
벤치마크의 목적을 다루는 의견도 있었다. 한 사용자는 로슨이 ‘최종 순위표’를 만들려는 게 아니라 근거로 선택할 수 있음을 보이려 했다고 설명한 대목이 글 끝에 묻혔다고 봤다. 독자들이 결과를 프레임워크 선택표로 받아들일 가능성이 큰 만큼, 시험의 용도를 앞에서 더 분명히 했어야 한다는 주장이다.
새 프레임워크로 옮기는 대신 기존 도구를 AI로 고칠 수 있다는 경험담도 나왔다. 한 사용자는 오랫동안 써 온 미스릴(Mithril)에 에이전트를 이용해 상태 관리, 타입, SSR 등을 보강했으며, 기존 테스트가 변경 사항을 확인하는 데 도움이 됐다고 했다. 이는 AI의 역할이 코드베이스를 갈아엎는 데만 있지 않다는 관점이다.
브라우저 작동 방식에 주목한 사용자는 콘텐츠를 보여 주는 사이트라면 JavaScript로 DOM(웹페이지 요소의 구조)을 많이 조작하는 프레임워크보다 HTML을 전달하는 방식이 알맞다고 주장했다. 반론은 상호작용이 많은 화면에서는 HTML 문자열만으로 이벤트를 처리하기가 번거롭다는 것이었다. 같은 웹 앱이라도 읽기 중심 화면과 복잡한 조작 화면에 동일한 해법을 적용하기 어렵다는 논쟁이다.
시험이 지나치게 단순하다는 지적도 이어졌다. 한 사용자는 프레임워크 선택에 팀의 지식, 장기 유지보수, 보안과 기능 개발 이력까지 들어간다며, 몇 달러와 몇 분을 아끼는 결과만으로 결론을 내리기 어렵다고 했다. 실제 상용 제품은 이번 앱보다 훨씬 복잡하다는 답글도 붙었다.
아스트로(Astro)의 결과를 긍정적으로 본 사용자는 빠른 제작 시간과 적은 비용, 클라이언트 측 JavaScript가 없는 점에 주목했다. 답글에서는 아스트로가 콘텐츠 중심 사이트를 겨냥하고 이번 과제도 그런 유형이었다는 설명이 나왔다. 실시간 데이터와 복잡한 상호작용을 넣으면 순위가 어떻게 달라질지가 다음 질문이라는 의견이다.
핵심통찰
AI가 코드를 작성해도 프레임워크 선택의 비용은 없어지지 않고 자리를 옮긴다. 사람이 문법을 익히는 시간 대신 에이전트가 문서를 찾고 코드를 생성하는 비용이 보이며, 배포 뒤에는 JavaScript 전송량과 수정할 코드의 크기가 남는다. 이번 시험은 콘텐츠 중심 앱에서 그 차이를 보여 줬다. 다음으로 지켜볼 것은 상호작용이 복잡한 앱에서도 같은 경향이 유지되는지, 프레임워크의 공식 에이전트 도구가 결과를 안정적으로 개선하는지다.
원본: The AI cost of JavaScript frameworks
토론: Hacker News